
Почему большие языковые модели могут стать новыми хакерами и что с этим делать
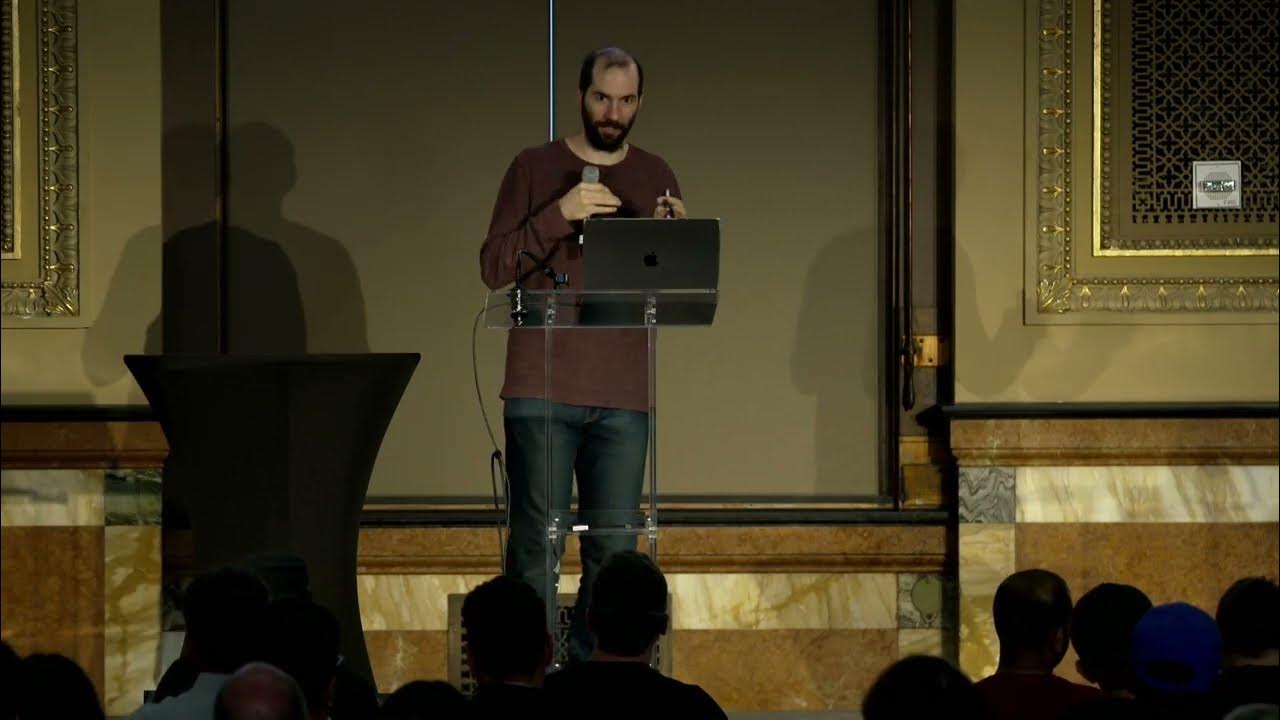
Николас Карлини из Anthropic рассказал на конференции [un]prompted 2026 крутую и в то же время немного пугающую штуку — большие языковые модели (LLM) уже научились автоматизировать сложные атаки, которые раньше делали только живые хакеры.
Представьте: эти модели могут находить "0-day" уязвимости — то есть дыры в коде, которые десятилетиями никто не видел, и использовать их для взлома. То есть мы получаем не просто ботов, а настоящих цифровых злодеев, которые работают быстро, масштабно и без отдыха.
Это меняет всю игру в безопасности — теперь защитникам придется учитывать машины, которые сами генерируют атаки. И если раньше на поиск багов уходили недели и месяцы, то теперь это может занять пару минут. В общем, будущее за теми, кто умеет думать и защищаться от таких "чёрных шляп".
Если вы интересуетесь тем, как ИИ влияет на безопасность и почему пора всерьёз задуматься об этих рисках, советуем посмотреть выступление Николаса — там много важных деталей и примеров. Видео доступно на YouTube: Nicholas Carlini - Black-hat LLMs | [un]prompted 2026.
А вы что думаете? Может, пора учиться защищаться от ИИ-хакеров уже сегодня?
Поделиться:
Ещё из архива
Все публикации
Интервью с Владимиром Аюевым: графический язык бигтеха, студия SASHA и дизайн-образование
1 месяц назад
Jockey от TwelveLabs: ИИ-агент для семантического поиска по видеоархивам и извлечения метаданных
1 месяц назад
Архитектура винной этикетки: баланс наборного шрифта и каллиграфии в кейсе Winecraft
1 месяц назад
Оптимизация контекста в Claude Code: как работает кэширование промптов и за что мы платим
1 месяц назад
Архитектура памяти для LLM-агентов: от базового SQLite до Graph RAG
1 месяц назад